La inferencia de modelos de lenguaje grandes (LLM) representa un desafío computacional significativo, especialmente en escenarios que demandan alta eficiencia y baja latencia. El método predominante de decodificación autorregresiva, que genera tokens secuencialmente, impone un cuello de botella inherente al throughput y la latencia, limitando la escalabilidad y la viabilidad económica de aplicaciones de IA intensivas.
Contexto técnico: La decodificación especulativa y sus optimizaciones
La decodificación especulativa surgió como una técnica para mitigar estas limitaciones. Consiste en utilizar un modelo borrador más pequeño y rápido para generar una secuencia de tokens candidatos, que luego son verificados en paralelo por el modelo grande. Si los tokens son correctos, se aceptan; de lo contrario, el proceso vuelve al último token aceptado y continúa la generación. Aunque esta técnica mejora la velocidad, los modelos borradores utilizados hasta la fecha a menudo han sido también autorregresivos, lo que, si bien más rápidos, aún no explota completamente el paralelismo potencial.
Innovación de DFlash en la generación paralela de tokens
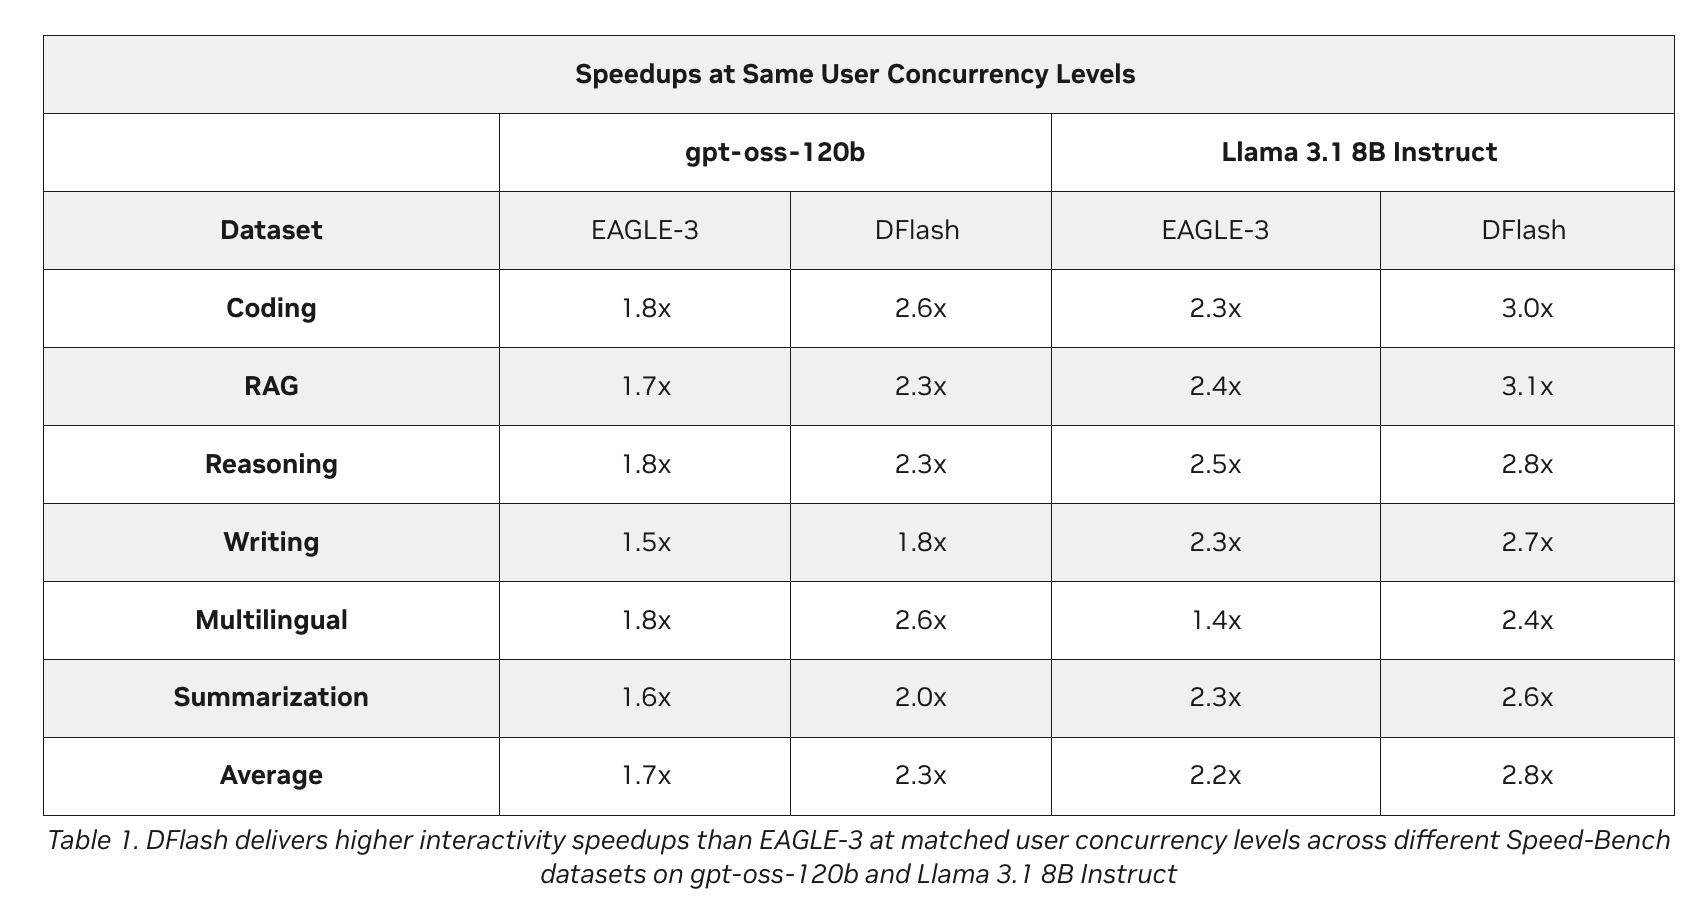
DFlash, una propuesta de UC San Diego, redefine la decodificación especulativa al reemplazar el modelo borrador autorregresivo con un modelo de difusión de bloques ligero. Esta innovación permite a DFlash generar bloques completos de tokens en un único paso hacia adelante, en lugar de token por token. La clave técnica radica en su capacidad para condicionar las características ocultas del modelo objetivo mediante la inyección KV (Key-Value injection). Este mecanismo asegura que los borradores generados por el modelo de difusión de bloques sean contextualmente relevantes y de alta calidad, maximizando la tasa de aceptación por parte del modelo principal sin sacrificar la precisión.
Impacto en el rendimiento y la arquitectura NVIDIA Blackwell
Los resultados preliminares son notables. DFlash ha demostrado una aceleración sin pérdidas de hasta 6.08x en el modelo Qwen3-8B. La proyección de hasta 15x mayor throughput se refiere específicamente a su implementación y optimización en la arquitectura NVIDIA Blackwell. La serie Blackwell, diseñada para cargas de trabajo de IA de próxima generación, incorpora capacidades de procesamiento paralelo y memoria avanzada que DFlash puede explotar de manera eficiente. Esta sinergia entre el algoritmo optimizado y el hardware de alto rendimiento es crucial para alcanzar tales niveles de eficiencia.
Implicaciones económicas y operacionales
Las implicaciones de DFlash son significativas para el ecosistema de la IA. Una mejora de hasta 15 veces en el throughput de inferencia se traduce directamente en una reducción sustancial de los costos operativos para los proveedores de servicios de LLM. Las empresas que despliegan modelos de IA a gran escala podrán atender a un mayor número de usuarios con la misma infraestructura o reducir la inversión en hardware para mantener los niveles de servicio actuales. Esto democratiza el acceso a la IA avanzada, haciendo que la ejecución de LLM sea más accesible y económicamente viable para un espectro más amplio de aplicaciones y empresas. Además, la menor latencia abre la puerta a nuevas aplicaciones en tiempo real que antes eran inviables, como asistentes virtuales altamente responsivos, sistemas de generación de contenido dinámico o interfaces hombre-máquina más fluidas y naturales.
La optimización de la inferencia de LLM sigue siendo un campo activo de investigación y desarrollo. La adopción de técnicas como DFlash en entornos de producción a gran escala determinará su impacto a largo plazo en la economía de la IA. Será fundamental monitorear el despliegue de estas innovaciones en plataformas de nube y servicios de API para evaluar su adopción generalizada y su capacidad para transformar la infraestructura de inferencia de IA.