IA
DFlash: Avance en la inferencia de LLM con decodificación especulativa en NVIDIA Blackwell
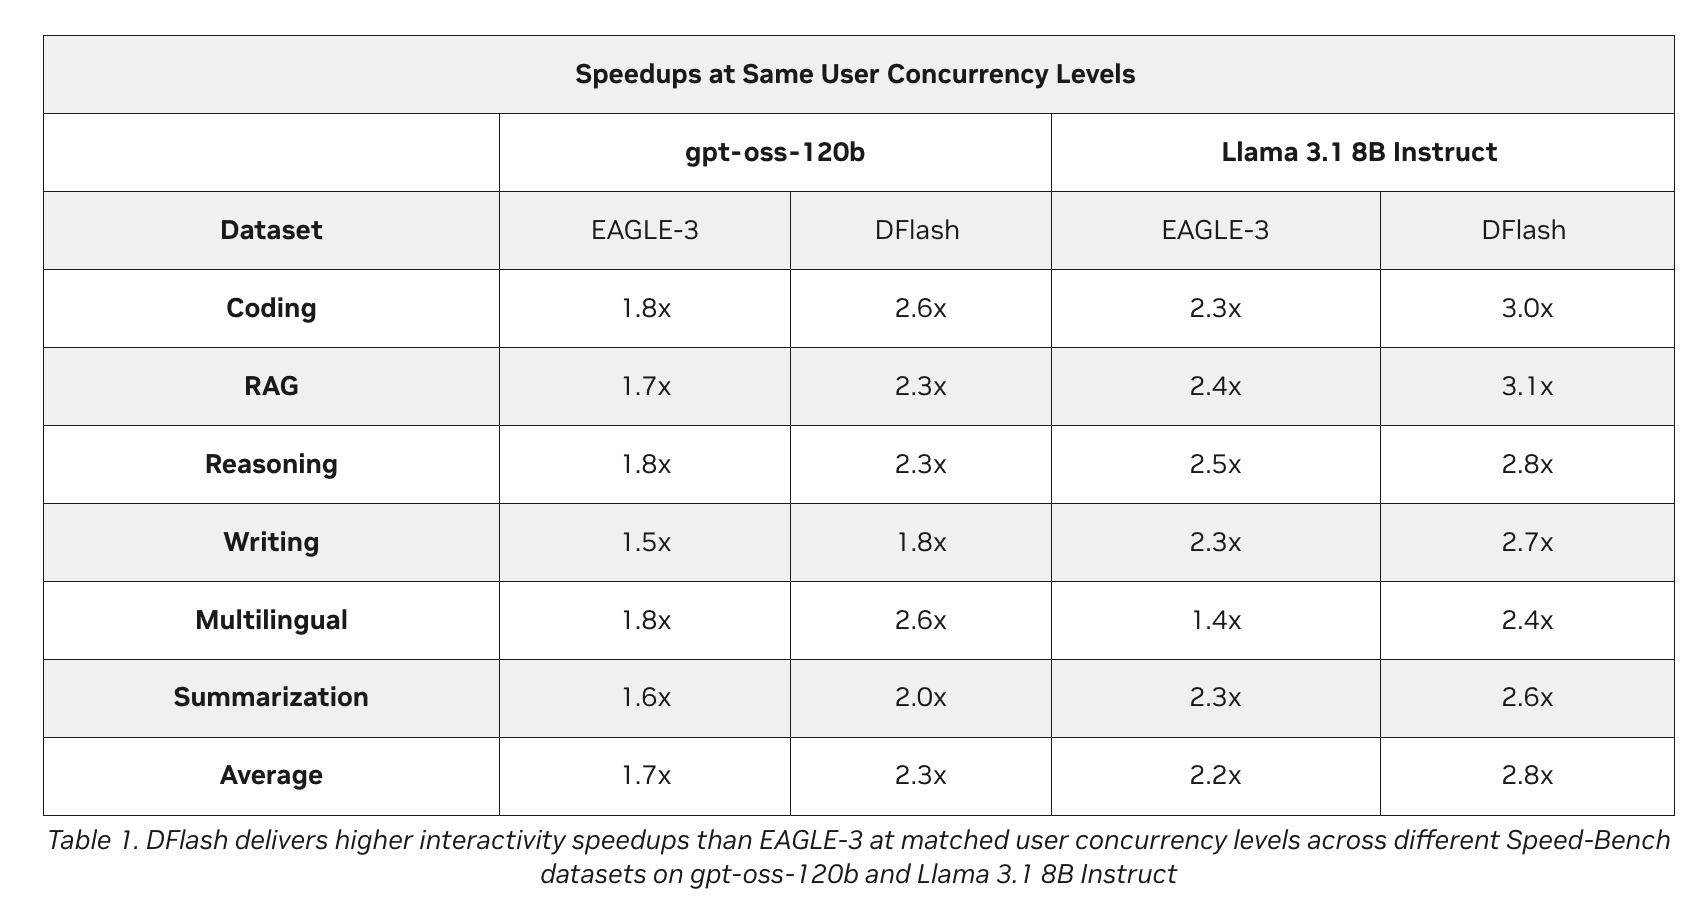
DFlash, desarrollado por UC San Diego, introduce un modelo de difusión de bloques para la decodificación especulativa, reemplazando la generación autorregresiva. Este método permite el borrador de bloques completos de tokens en un solo paso hacia adelante, condicionando características ocultas a través de la inyección KV. Los resultados preliminares reportan hasta 6.08x de aceleración sin pérdidas en Qwen3-8B y un rendimiento máximo de 15x en arquitecturas NVIDIA Blackwell.
Carlos "Emérito" López Lovera